





1965 年,英国骨科医生迈克尔·弗里曼(Michael Freeman)注意到一个奇怪的现象:不少人崴脚之后,韧带明明没有严重松弛,却总觉得脚踝“发软”“打滑”,而且反复在同一只脚上崴伤。他把这种情况称为踝关节的“功能性不稳”,并提出一个当时颇为新颖的解释:问题未必出在韧带本身,而可能出在关节向大脑传递位置信息的“本体感觉”上。
半个多世纪后,这个问题依然困扰着运动医学。论文援引的研究显示,在经常运动的人群中,踝关节扭伤的发生率在 16% 到 40% 之间,约占下肢运动损伤的 15% 到 20%。而第一次崴脚的人中,约有 40% 会发展为慢性踝关节不稳(chronic ankle instability,下文简称 CAI):反复扭伤、关节“打软腿”,长期下来还会增加创伤后骨关节炎的风险。
它的代价也不小。荷兰的一项全国性测算显示,踝关节扭伤每年造成约 1.87 亿欧元的损失,其中近 80% 来自误工带来的生产力损失。
可是,一个人崴脚后到底恢复得怎么样,现在主要靠问卷和医生的判断。
近日,宁波大学体育学院顾耀东团队联合匈牙利、荷兰、英国、瑞典、新西兰等地的研究人员,在 Advanced Science 上发表论文,提出了一套评估 CAI 的人工智能框架。
研究人员让受试者从 40 厘米高的跳箱上单腿落下,同时记录腿部 10 块肌肉的表面肌电信号。模型从这些信号中提取肌肉之间的“协同模式”,在 150 名受试者中,它区分 CAI 患者和健康人的准确率达到 98.5%;进一步区分 CAI 的两种亚型,准确率为 87.7%。更重要的是,它还能把判断结果换算成一个 0 到 100 的连续“运动功能分”,这个分数与临床常用的足踝功能量表高度相关。
简言之就是:不再只问患者“脚踝感觉怎么样”,而是让肌肉自己“说话”,再由 AI 翻译成一个可以追踪的分数。
那么,肌肉的电信号里藏着什么?这个分数又能在多大程度上代替医生的判断?
“感觉好了”,不等于真的好了
先说说现有评估方法的难处。
目前临床上常用足踝能力量表(FAAM)、美国足踝外科协会评分(AOFAS)等工具来评价踝关节功能。它们大多是等级量表,很大程度上依赖患者的自我感受和医生的主观判断。
论文指出,这类量表还有一个明显的问题:“天花板效应”。功能较好的患者在康复早期就能拿到接近满分的成绩,之后即使还有细微但有临床意义的缺陷,量表也很难再反映出来。已有研究发现,即便患者自我感觉恢复得不错,用精密的运动捕捉系统仍能看到下肢动作模式的异常。
那么,用客观的生物力学数据行不行?此前已有不少研究用关节角度、受力、肌力、关节活动度等指标,结合机器学习来识别 CAI。
问题在于,人体很会“打掩护”。论文指出,CAI 患者为了弥补脚踝的不稳和本体感觉受损,常在落地时更多地依靠髋关节或膝关节来缓冲。这种代偿会把脚踝本身的问题“藏”起来,让单纯看动作外在表现的指标失去区分度。
磁共振、超声等影像学方法可以看清韧带的结构损伤,但它们反映的是“结构”,而非“功能”,也不适合反复检查、追踪康复进程。论文还指出,影像所见与患者实际感受到的不稳之间,常常并不一致。
此外,CAI 本身也并非一种病。临床上通常把它粗分为两类:一类是韧带确实松弛的“机械性不稳”(MAI),另一类是韧带检查正常、但患者反复感到“打软腿”的“功能性不稳”(FAI),后者正是弗里曼当年描述的那种情况。两类患者的康复重点并不相同,但以往的识别模型大多把 CAI 当作一个整体来对待。
读懂肌肉的“分工表”
团队想到的切入点,是“肌肉协同”。
一个看似简单的落地动作,需要腿上十几块肌肉在几百毫秒内按特定顺序、特定力度配合发力。神经科学研究认为,大脑并不是一块一块地单独指挥这些肌肉,而是把它们编成几个“小组”,以小组为单位下达指令。
这有点像一支乐队:指挥家不会逐一指挥每件乐器,而是指挥弦乐组、管乐组、打击乐组。每个“声部”里各乐器的音量配比,就是协同的“空间结构”;每个声部何时进入、何时最响,就是协同的“时间结构”。
从肌电信号中把这两部分拆出来,用的是一种叫非负矩阵分解的数学方法。拆出来的结果,既能反映中枢神经系统的协调策略,又有比较清晰的生理含义。
研究共纳入 150 名受试者,平均年龄约 24 岁:100 名单侧 CAI 患者和 50 名健康对照。CAI 患者又按临床检查分为两组,各 50 人:用关节测量仪检查,距骨前移比健侧多 3 毫米以上,或距骨倾斜角比健侧多 5 度以上的,归为机械性不稳;没有客观韧带松弛、但反复扭伤和“打软腿”的,归为功能性不稳。
每名受试者用患侧(同时也是优势腿)双臂交叉抱胸,完成 5 次单腿跳落。研究人员用 16 通道无线肌电系统,以每秒 1,000 次的频率记录肌电信号。
分析显示,单腿落地这个动作,大体可以由 4 个肌肉协同“小组”来完成。
第一组是“初始刚化”,以股二头肌、腓肠肌内侧头和胫骨前肌为主,负责落地前的准备和触地瞬间让关节迅速“绷紧”。第二组是“冲击吸收”,主要由大腿和臀部肌肉组成,通过屈膝屈髋来缓冲冲击力。第三组是“膝主导制动”,由股直肌、腓肠肌外侧头和比目鱼肌驱动,负责减速和前后方向的平衡。第四组是“内外侧稳定”,由小腿的腓肠肌和腓骨长肌组成,专门控制脚踝的内翻、外翻和左右方向的姿态稳定。
与健康人相比,三组不稳患者在各个“小组”内的肌肉权重配比和激活的时间进程上,都出现了明显的偏离。另一个有意思的发现是:功能性不稳患者需要的协同数量显著多于健康人,也多于机械性不稳患者。这或许意味着,他们的神经系统在用一种更“零碎”的方式指挥肌肉。
层层投票的“评审团”
有了这些特征,接下来是建模。
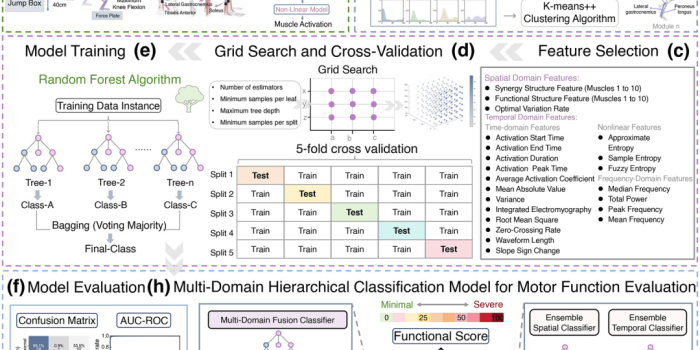
团队从协同数据中提取了 3 类空间特征(如各肌肉的权重分布)、19 种时间特征(如激活起始时间、峰值时间、信号幅度、频谱和熵值等),以及反映协同复杂度的特征(如最优协同数量、方差解释率等)。
他们没有把这些特征一股脑地塞进一个模型,而是搭了一个分层结构。
可以把它想象成一个三级评审团。第一级,两位“初审专家”分别只看空间特征和时间特征,各自给出“此人像 CAI 的概率”。第二级,两位“复审专家”在初审意见的基础上,再对照健康人的标准“小组”模板,看看此人的协同模式有多相似。第三级,“终审专家”综合两位复审的意见,再参考协同的整体复杂度,做出最终判断。
每一级用的都是随机森林算法。训练时,团队按受试者划分数据,60% 的人用于训练、40% 的人用于独立测试,训练集内部再按 4:3:3 分给三级模型,避免“自己考自己”。
结果显示,层层“评审”确实有用。只看空间特征的初审模型,区分 CAI 与健康人的准确率为 88.3%;只看时间特征的为 85.1%。经过复审,分别提升到 92.3% 和 88.8%。而最终的多域融合模型达到 98.5%,曲线下面积(AUC)为 0.99。在测试集的 200 次落地记录中,它只漏判了 1 次、误判了 2 次。
区分三类人(健康、功能性不稳、机械性不稳)要难得多。融合模型的总体准确率为 87.7%。它识别健康人的准确率约为 99%,难点在于区分两种亚型:功能性不稳的识别率为 88.5%,而机械性不稳只有 73.6%。
论文对此的解释是,功能性不稳主要源于本体感觉和感觉运动控制受损,这恰好会体现在肌电信号里;而机械性不稳的核心是韧带结构松弛,虽然也会引起一些代偿性的肌肉调整,但结构问题本身并不能完全从肌电中“读”出来。换句话说,这套方法更擅长发现“神经肌肉控制”层面的问题。
从“是不是”到“有多重”
判断“是不是 CAI”只是第一步。这项研究更想解决的,是“有多重”和“好了多少”。
团队的思路是:既然模型能输出“此人像 CAI 的概率”,那就把每个人 5 次落地的概率取平均,再线性换算成 0 到 100 分。分数越高,说明肌肉协同模式越接近病理状态;分数越低,越接近健康人。
这个分数靠不靠谱?团队把它与临床常用的 FAAM 量表做了对比(FAAM 分数越高表示功能越好,因此两者应呈负相关)。结果显示,融合模型的评分与 FAAM 的相关系数为 −0.908,在功能性不稳和机械性不稳亚组中也分别达到 −0.906 和 −0.894。
在这个分数上,健康人大多落在 20 到 40 分之间,CAI 患者则集中在 60 到 90 分,两组重叠很少。以 62 分为界,识别 CAI 的灵敏度为 98%,特异度为 90%。
为了让分数更“好读”,团队还借用 FAAM 的临床界值做了换算:FAAM 90 分大致对应模型的 53.7 分,被定为“轻度受损”的门槛;FAAM 75 分对应 67.6 分,被定为“重度受损”的门槛。按这个标准分组后,健康、轻度、重度三组的多项肌电和协同特征呈现出逐级变化,说明这种分级有一定的生理依据。
AI 常被诟病是“黑箱”。为了看清模型依据的是什么,团队用 SHAP 方法分析了各个特征对判断的贡献。
结果显示,在空间特征中,最关键的是小腿腓肠肌内、外侧头在协同中的权重:权重越低,越可能被判为 CAI。这与临床上观察到的 CAI 患者小腿后侧肌肉激活减弱一致。大腿的股二头肌和股外侧肌也榜上有名,说明脚踝不稳影响的不只是脚踝,而是整条下肢的协调。
在时间特征中,激活起始时间和峰值时间偏晚、肌电频谱的峰值频率和中位频率偏低,都会把判断推向 CAI。也就是说,患者的肌肉不仅“使劲的配比”变了,“使劲的时机”也慢了半拍。
进一步的分析还发现了一些“拐点”。比如,当腓肠肌外侧头的协同权重降到约 0.23 以下、内侧头降到约 0.51 以下时,它们对功能受损评分的推动作用会急剧增大。论文认为,这或许提示,肌肉协同的退化在一定范围内可以被代偿,一旦越过某个界限,代偿就“兜不住”了。这些拐点未来或可作为康复监测的参考,但论文也强调,它们是否真的代表有临床意义的转折点,还需要纵向研究来确认。
论文还设想,这些可解释的结果可以直接指导康复。比如,如果发现某位患者比目鱼肌和胫骨前肌的配合出了问题,康复方案就可以侧重训练这两块肌肉的协调发力,而不只是单纯地加强肌力。
离“随身打分”还有多远?
这项研究把肌肉协同、分层融合和可解释 AI 组合在一起,给“崴脚后恢复得怎么样”提供了一种客观、连续的量化思路。团队已在 Figshare 上公开了完整数据集,在 GitHub 上公开了模型代码。但从论文内容看,距离临床落地还有不少问题需要回答。
作者在论文中列出了几项主要局限。首先,样本量仍然有限,而 CAI 患者在年龄、功能状态和代偿策略上差异很大,模型需要在更大规模的多中心数据中验证。其次,这是一项横断面研究,只在一个时间点测量了每个人,并没有真正追踪患者在康复过程中的分数变化。团队表示,下一步计划开展有重复评估的前瞻性队列研究。第三,SHAP 解释本身依赖模型结构和输入变量,可能存在偏差。最后,目前的系统还是科研用的脚本程序,尚未做成临床人员可以直接使用的软件。
除此之外,还有几点值得留意。
第一,虽然论文强调“可穿戴肌电传感器驱动”,但实验是在实验室里完成的:落地时刻由测力台判定,膝关节最大屈曲由光学运动捕捉系统确定,肌电还需按最大自主收缩做归一化。要在诊所或家中用便携设备复现同样的精度,还需要解决动作分段、电极位置一致性等工程问题。
第二,受试者是一群平均 24 岁、平均体重约 78 公斤的年轻人,来自单一中心,且是回顾性纳入的,研究的临床注册也是事后补登。模型在青少年、中老年人或高水平运动员中是否同样有效,尚不清楚。
第三,这个“功能分”本质上衡量的是“肌肉协同模式有多像 CAI 患者”,而非直接测量功能本身。健康人的得分也落在 20 到 40 分,而不是 0 分。此外,用来锚定轻、重度的换算区间相当宽:“轻度受损”门槛 53.7 分的 95% 预测区间为 45.6 到 61.7 分,“重度受损”门槛 67.6 分的预测区间为 60.0 到 75.2 分,两者有所重叠。而且“轻度受损”门槛低于区分 CAI 与健康人的诊断界值 62 分。这些分级在个体层面使用时,需要谨慎解读。
第四,测试集的 200 次落地记录来自约 40 名受试者,同一个人的 5 次落地彼此高度相关,按“次”统计的准确率可能比按“人”统计更乐观。另外,论文摘要提到的“外部验证”,实际是把模型在扩充后的 CAI 亚型样本上直接运行,并非来自另一家机构的独立队列。
第五,区分机械性不稳的准确率仍不够高,这类以韧带结构问题为主的患者,可能仍需结合体格检查或影像学来判断。
论文的设想是,未来这套系统可以走出医院,让患者在日常生活中定期“打卡”测一测,医生据此实时调整康复方案,减少反复就诊和影像检查。
1965 年,弗里曼提出“功能性不稳”时,能用来衡量本体感觉的工具还非常有限。60 年后,研究人员已经可以从一次 40 厘米的单腿跳落中,读出十几块肌肉的分工与时序,并把它们翻译成一个分数。
路还很长。但至少,“崴脚之后到底好了没有”这个问题,正在有机会从一句“感觉还行”,变成一条可以被追踪的曲线。
参考资料
1.Jie, T., Xu, D. et al. An Interpretable, Data-Driven, Hierarchical Multi-Domain Fusion Framework for Classification and Motor Function Scoring in Chronic Ankle Instability. Advanced Science 13, e77212 (2026). https://doi.org/10.1002/advs.77212
2.Freeman, M. A. R. Instability of the foot after injuries to the lateral ligament of the ankle. Journal of Bone and Joint Surgery (British) 47, 669–677 (1965).
3.Doherty, C. et al. Recovery From a First-Time Lateral Ankle Sprain and the Predictors of Chronic Ankle Instability. The American Journal of Sports Medicine 44, 995–1003 (2016).
审核 | 医工学人理事会
