





1909 年前后,德国科学家保罗·埃尔利希(Paul Ehrlich)和日本助手秦佐八郎在实验室里,一个接一个地测试砷化合物对梅毒病原体的作用。编号第 606 号的化合物最终脱颖而出,后来以“洒尔佛散”(Salvarsan)之名上市,成为现代化学疗法的开端。
埃尔利希一生追求的,是一种“魔弹”(magic bullet):只击中病原体或病变细胞,而不伤及身体其他部分的药物。
一百多年后,新药研发依然像在大海里捞针。论文援引的数据显示,把一款新药从概念推进到临床,往往需要十年以上、耗资以十亿美元计,而进入 I 期临床试验的候选药物中,约 90% 最终无法获批,失败原因主要是疗效不足和意料之外的安全问题。
其中一个重要难点在于,判断一个靶点值不值得做,需要综合遗传学、单细胞测序、蛋白结构、临床试验等大量证据,而这些数据和专业知识分散在不同团队、不同数据库里,很难被整合起来。
近日,美国斯坦福大学詹姆斯·邹(James Zou)团队在 Science 上发表论文,提出了一个名为“虚拟生物技术公司”(The Virtual Biotech)的多智能体 AI 系统。论文第一作者为斯坦福大学研究生哈里森·张(Harrison G. Zhang)。
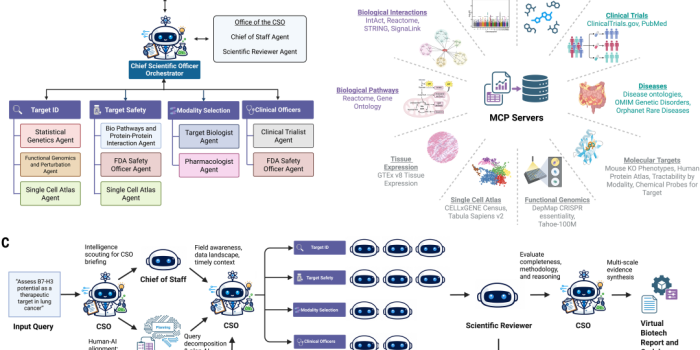
这家“公司”仿照真实药企的组织架构搭建:一位 AI“首席科学官”接收人类提出的科学问题,再把任务分派给分属四个部门的 AI“科学家”,最后汇总各方证据,给出结论。
在一项任务中,它一次性派出 37,075 个 AI 智能体,逐一梳理了约 5.6 万项临床试验的结果,发现靶向“细胞类型特异性基因”的药物,最终上市的可能性高出 48%,不良事件发生率低 32%。
简言之就是:用一群分工明确、互相审稿的 AI,模拟一家药企的研发团队,帮人类科学家做新药研发早期的证据整合和决策参考。那么,这家没有一个人类员工的“公司”是怎么运转的?它的结论有多可靠?
一家“没有人”的公司
先看看这家公司的组织架构。
论文介绍,系统共有 11 个智能体。其中 8 个“科学家”分属四个部门:
“靶点发现与优先级排序”部门,负责从遗传学、功能基因组学和单细胞层面判断一个靶点与疾病是否真的相关;“靶点安全性”部门,结合通路、蛋白互作、各类细胞中的表达情况和 FDA 历史安全信号,评估脱靶和副作用风险;“药物形式选择”部门,判断这个靶点更适合用小分子、抗体还是其他药物形式来打;“临床”部门,则负责梳理此前的临床试验和监管数据。
另外 3 个智能体组成 “首席科学官办公室”:首席科学官本人只负责拆解问题、分派任务、综合判断,自己从不直接碰数据;“幕僚长” 负责快速摸清领域背景和数据情况;“科学审稿人” 则专门挑刺,检查各位科学家的分析是否回答了问题、证据是否扎实、是否足够全面。如果发现漏洞,首席科学官会把任务连同审稿意见退回去重做。
这有点像一家真实药企的周会:项目负责人提出问题,遗传学、生物信息、毒理、临床各组分头准备材料,内部评审挑毛病,最后由研发负责人拍板。论文认为,这种与人类组织一一对应的结构还有个好处:每个 AI“岗位”的工作,都可以交给对应领域的人类专家来审核。
为了让这些 AI 科学家“有活可干”,团队搭建了 10 个 MCP 服务器、100 多个定制工具,把多个公开数据库接入系统。论文列出的数据规模包括:7.8 万多个靶点、近 4 万种疾病、1,450 万对蛋白质相互作用、超过 1 亿个单细胞图谱数据、1.8 万多种药物、11.4 万多份 FDA 不良事件报告,以及来自 Tahoe-100M 数据集的 40 多亿个药物扰动基因表达测量值。
论文的方法部分显示,大部分智能体运行在 Anthropic 公司的 Claude Sonnet 4.5 模型上,“幕僚长”和“科学审稿人”则使用更轻量的 Claude Haiku 4.5,系统基于 Claude Agent SDK 搭建。
人类在其中扮演什么角色?论文描述,用户主要负责提出高层次的科学问题、回答首席科学官的澄清提问,并在每轮分析后追问或要求补充分析;实验思路的提出、设计和执行,则由智能体自主完成。所有分析代码和数据都可以下载,供人类复核。
3.7 万名“临床试验专员”
团队给这家公司布置的第一项大任务,是回答一个药企最关心的问题:什么样的靶点更容易成功?
此前已有研究发现,有人类遗传学证据支持的靶点,药物获批的可能性要高出一倍以上。团队把这些研究“喂”给系统,让它自己评估还能往哪个方向拓展。
首席科学官与各部门“讨论”后提出了一个方案:利用公开的 Open Targets 数据库中约 5.6 万项临床试验,补全每项试验的结果信息,再看看靶点的单细胞特征与试验成败有没有关系。
难点在于数据本身。Open Targets 数据库不包含试验终点数据,而 ClinicalTrials.gov 上的记录经常不完整、格式不统一,甚至只有一段自由文本。要逐项核对,人工几乎不可能完成。
于是,系统为 II 期和 III 期临床试验各派出一个“临床试验专员”智能体,共 37,075 个,并行工作。每个智能体只负责一项试验:先查 ClinicalTrials.gov,信息不全再查 PubMed 上的论文,还不够就去找新闻稿和监管公告,并记录每条信息的来源。
论文指出,这种“一人一案”的设计,让每个智能体能把全部注意力放在一项试验上,不会因为同时处理太多任务而“分心”。全部 37,075 项试验在 6 小时内处理完毕;论文估算,如果交给单个智能体串行处理,需要约 76.6 天。
AI 整理的数据靠不靠谱?团队随机抽取了 100 项试验,由两名人类标注员独立核对。结果显示,在主要终点、次要终点和不良事件发生率上,AI 与人类的一致率分别为 89.7%、83.9% 和 92.4%。在另一个人工整理的数据集中,有 7,278 项试验与之重叠,二者在主要终点上的一致率为 85.3%。
论文分析,分歧大多出现在本身就模棱两可的情况,比如多个试验组有的达标、有的没达标,或者主要终点的 p 值恰好为 0.051。
“魔弹”式靶点,更容易成功?
数据准备好后,单细胞智能体提出了两个衡量靶点特征的指标。
第一个是“细胞类型特异性”。它衡量一个基因是在各种细胞里都表达,还是只在少数几类细胞里表达,取值从 0 到 1,越接近 1,说明表达越集中。
第二个是“表达双峰性”。它衡量在同一类细胞中,这个基因的表达是否呈现“要么开、要么关”的开关式模式。有意思的是,这个指标在心理学和社会科学中很常用,在单细胞分析中却很少见。论文认为,这体现了 AI 的跨领域知识迁移。
打个比方,如果把药物比作广告,那么靶向一个只在特定细胞中表达的基因,就像只在目标客户的小区里精准投放;而靶向一个到处都表达的基因,则像全城撒传单,难免“误伤”无关的人群。
分析结果显示,两个指标都与试验成败显著相关。把靶点按细胞类型特异性分为“特异性表达”和“广泛表达”两类后,靶向特异性表达基因的药物,从 I 期推进到 II 期的可能性高出 40%,最终进入 IV 期(即上市后阶段)的可能性高出 48%。
安全性方面,这类试验在感染、胃肠道、心脏、血液、神经、呼吸、血管和肾脏等多个器官系统中的不良事件发生率都更低,平均低了 32%。
表达双峰性得分较低的靶点,则与试验被终止、撤回或暂停的风险更高相关。
团队还做了一系列稳健性检验:用 1,000 次随机置换检验排除偶然性;把药物类型、疾病领域、试验分期和开始年份纳入混合效应模型,结果依然显著。更重要的是,在校正了遗传学证据后,单细胞特征的效应几乎没有减弱;而在约四分之三没有遗传学证据的试验中,单细胞特征的效应同样存在,甚至更强。
论文认为,这说明单细胞特征提供了遗传学证据之外的独立信息,可以作为靶点评估的新依据。此前已有研究发现细胞类型特异性靶点与早期分期推进相关,但没有研究它与安全性和试验终点的关系。
邹在斯坦福医学院的新闻稿中表示:“这表明这些单细胞特征可以帮助做出更好的药物,也说明收集这类数据的重要性。”
一份 46 美元的靶点评估
除了大规模数据挖掘,团队还想看看这家“公司”能否像药企研发团队一样,对一个具体靶点做深入评估。
他们选择了 B7-H3(又名 CD276)。这是一种免疫检查点蛋白,在多种实体瘤中高表达,但它的受体至今未知,在癌症中的作用也不完全清楚。团队让系统评估它作为肺腺癌和小细胞肺癌治疗靶点的潜力。
为了防止 AI“偷看答案”,这次分析关闭了网络搜索功能,而底层模型的训练数据截止于 2025 年 1 月。
首先,统计遗传学智能体发现,B7-H3 基因座与肺癌之间没有显著的遗传关联。但首席科学官判断,对免疫检查点类靶点来说,治疗依据主要来自肿瘤中的过度表达,而非遗传风险,因此这一结果并不构成“一票否决”。
接下来,单细胞智能体分析了约 50 万个细胞的数据,发现 B7-H3 的升高主要集中在肿瘤周围的成纤维细胞中,而不是均匀地出现在所有细胞里。它进一步推测,这些 B7-H3 高表达的成纤维细胞可能在主动“营造”一个抑制免疫的微环境。
这时,科学审稿人提出了质疑:单细胞数据是把组织打散后测得的,丢失了细胞的空间位置信息,凭此推断细胞间的“对话”不够有说服力。
于是,首席科学官又派单细胞智能体去分析 12 例肺腺癌的空间转录组数据。结果显示,B7-H3 高表达区域周围的 T 细胞、巨噬细胞等免疫细胞明显减少,呈现出“免疫排斥”的特征。临床试验专员随后在 566 名肺腺癌患者的数据中发现,B7-H3 高表达的患者总生存期和疾病特异性生存期都更差。
最后,在药物形式上,系统发现 B7-H3 位于细胞表面、缺乏可结合小分子的“口袋”,因此排除了小分子药物,建议开发抗体偶联药物(ADC),也就是把细胞毒性药物“挂”在抗体上,精准送到表达 B7-H3 的细胞处。
整个分析耗时不到一天,API 费用为 46 美元。
论文特别提到,2025 年 8 月,也就是模型训练数据截止之后,一款靶向 B7-H3 的 ADC 药物 ifinatamab deruxtecan 在小细胞肺癌 II 期试验中取得 48.2% 的客观缓解率,并获得 FDA 突破性疗法认定。论文认为,这为系统的推理提供了独立的外部支持。
团队还用系统复盘了一项失败的临床试验。
这项名为 MOONGLOW 的 II 期试验,测试的是一种靶向抑瘤素 M 受体(OSMRβ)的“首创”单克隆抗体 vixarelimab,用于治疗中重度溃疡性结肠炎。试验在入组 79 人后,因期中分析显示难以达到主要终点,于 2025 年 8 月终止。
系统发现,OSMR 有很强的遗传学证据支持,但在溃疡性结肠炎组织与健康组织中,它的表达并没有显著差异。随后,它从公开数据库中找到 5 项使用不同生物制剂的溃疡性结肠炎试验,发现无论哪种药物,治疗无效的患者在治疗前的 OSMR 表达都显著更高。
据此,系统推测,MOONGLOW 的失败可能源于一个“精准医疗缺口”:试验没有按 OSMR 表达水平筛选患者,许多受试者体内可能根本没有激活这条通路。它建议在未来的试验中,优先招募 OSMR 高表达的患者。
论文指出,此前尚无研究明确提出把 OSMR 作为这类试验的患者分层标志物。这次分析同样耗时不到一天,花费 54 美元。
AI 能替代药企研发团队吗?
论文认为,与传统研发流程相比,这套系统的优势在于跨部门证据的深度整合、更客观可追溯的决策过程,以及速度和规模。但论文和公开报道中也有不少值得冷静看待的地方。
作者在论文中列出了几项主要局限。首先,AI 智能体会出错,而在一个“组织”里,一个错误可能层层传递。虽然设置了科学审稿人,但人类专家仍需参与。其次,临床试验分析属于观察性研究,只能说明相关,不能证明因果;而且只覆盖了 ClinicalTrials.gov 上登记、靶点明确的试验。第三,两个案例研究给出的都只是由数据驱动的假设,仍需实验验证。最后,语言模型在预训练中可能已经“见过”相关信息,从而偏向既有假设。据 Science 的新闻稿,作者还指出,系统的结论受限于现有数据的质量和广度,目前还不适用于研究较少的疾病或靶点。
除此之外,还有几点值得注意。
第一,关于 B7-H3 的“独立验证”需要准确理解。靶向 B7-H3 的抗体和 ADC 并不是新思路,论文自己也承认,此前已有不少针对它的药物研发项目。ifinatamab deruxtecan 在 2025 年之前就已进入临床试验,并非在模型知识截止后才出现。部分媒体报道称 AI“独立设计”了一款后来被药企开发的药物,这种说法有所夸大。从论文看,系统真正的新意,在于提出 B7-H3 主要在成纤维细胞中升高、与免疫排斥相关这一视角。而 FDA 的突破性疗法认定只能说明 ADC 这一方向在临床上有前景,并不能证明 AI 的这条推理链条本身是对的。
第二,关于“48% 更可能上市”的发现,它是对历史数据的统计关联。靶向特异性表达基因的药物成功率更高,可能也与这类靶点的疾病领域、研发难度等难以完全校正的因素有关。它能否作为前瞻性的靶点筛选标准,还需要在新的研发项目中检验。
第三,“46 美元”只是 API 调用费用,不包括背后数据库的建设与维护、系统开发,以及人类专家审核的成本。系统表现在很大程度上也依赖底层的商业大模型。
此外,公开报道中的部分数字与论文并不完全一致,比如有报道称分析了“约 5 万项试验”“耗时不到一周”。本文以论文预印本中的数据为准。需要说明的是,Science 正式版论文可能在细节上与预印本有所不同。
团队已在 GitHub 上公开了系统代码。邹在斯坦福医学院的新闻稿中表示,团队不会继续推进 B7-H3 这一靶点,但系统已经以类似方式找到了其他候选靶点。“我们的下一步,是把虚拟生物技术公司的新发现带进真实的实验室,检验其中有多少能在现实世界中站得住脚。”
一百多年前,埃尔利希和秦佐八郎为了找到一颗“魔弹”,需要一个化合物一个化合物地测试。今天,研究人员可以在一夜之间派出数万个 AI 智能体,翻遍数万项临床试验,并发现那些更接近“魔弹”的靶点,确实更可能走到最后。
路还很长。但至少,在新药研发最早、也最依赖经验判断的阶段,人类科学家多了一支可以随时调用、并且会把每一步推理都摊开给人看的“虚拟团队”。
参考资料
1.Zhang, H. G., Eckmann, P., Miao, J., Mahon, A. B., Zou, J. The Virtual Biotech: A multi-agent AI framework for therapeutic discovery and development. Science (2026). https://doi.org/10.1126/science.aeg6779
2.Stanford Medicine 新闻稿(经 Phys.org 转载):https://phys.org/news/2026-09-virtual-biotech-company-thousands-ai.html
3.EurekAlert!(AAAS)新闻稿:https://www.eurekalert.org/news-releases/1143742
审核 | 医工学人理事会
