





在肿瘤精准医疗领域,多模态数据整合长期受困于“数据孤岛”与工程化瓶颈。美国莫菲特癌症中心与南佛罗里达大学团队在《npj Digital Medicine》发表研究,推出开源框架HONeYBEE。
该框架基于领域基础模型生成患者级统一嵌入,在11,400+名患者、33种癌症类型中验证:临床嵌入单模态分类准确率达98.5%,检索精度@10达96.4%。更令人意外的是,通用大模型Qwen3在临床文本表示上全面超越专业医学模型,为多模态肿瘤AI的规模化落地提供了全新范式。
数据孤岛与工程化困局
在肿瘤学AI领域,一个尴尬的现实长期存在:数据越丰富,整合越困难。
近年来,肿瘤学数据正经历前所未有的“数字化爆炸”。从结构化的临床变量(人口统计学、肿瘤分期、实验室结果),到非结构化的临床叙述(病理报告、影像报告、医生笔记),再到医学影像(放射扫描、全切片图像WSI)和高维分子图谱——这些多模态数据为患者分层、治疗反应预测和疾病进展建模提供了空前的机遇。
然而,正如论文所指出的,这些数据仍然碎片化地存在于不同模态中,通常被独立处理。这种“孤岛式”方法限制了跨模态互补信息的整合,无法实现以患者为中心的统合分析。
更棘手的是工程层面的问题。现有的多模态AI开发往往依赖碎片化的流程,需要手动协调各种模态专用工具:结构化临床数据用OHDSI、放射影像用PyDicom、病理图像用OpenSlide、组织病理处理用TIAToolbox。这种碎片化在协调跨模态元数据和管理不一致API时,引入了巨大的技术开销。
“尽管大规模生物医学数据在肿瘤学中日益可得且被积极分析,但它仍然碎片化地存在于不同模态中……这种孤岛式方法限制了整合跨模态互补信息以进行统一、以患者为中心分析的能力。”
虽然基础模型(FMs)的出现让单模态特征提取取得了显著进展——这些在文本、影像或分子数据上预训练的模型,能够学习捕捉领域特定模式的潜在表示——但在实践中,这些模型通常被应用于单模态或双模态工作流中,跨模态的互补信息仍未被充分利用。
研究团队提出了一个核心假设:整合来自多个数据模态的FM衍生嵌入,可以产生更丰富、更具临床信息量的患者表示,尤其是在临床数据不完整或结构化程度较低的场景中。他们主张,与其单纯依赖模型缩放或增加参数量,不如融合来自不同生物医学数据类型的互补信息,为提升肿瘤学预测性能提供一种强大的正交方法。
解构HONeYBEE框架
HONeYBEE(Harmonized ONcology Biomedical Embedding Encoder,协调肿瘤学生物医学嵌入编码器)是一个模块化、开源、可扩展的框架,旨在生成统一的患者级嵌入,支持下游肿瘤学任务。
1 核心架构:四大模态流水线
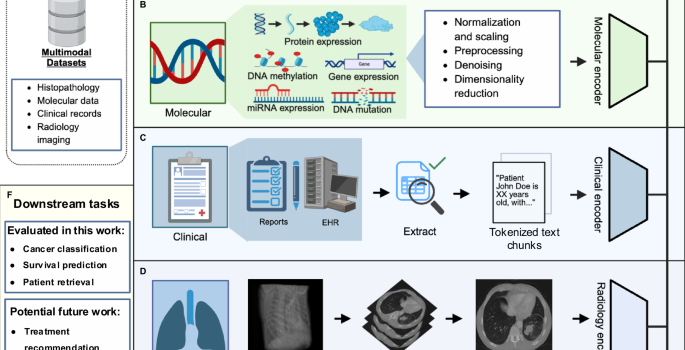
HONeYBEE为四种主要生物医学数据模态提供了专用处理流水线:全切片组织病理图像、放射影像、分子图谱和临床文本。每个模态专用流水线都集成了针对数据类型量身定制的最先进预处理技术,并利用领域特定FMs生成高质量、固定长度的数据表示(嵌入)。
2 模态特定嵌入生成
临床文本与病理报告:HONeYBEE支持多种语言模型,包括GatorTron、Qwen3、Med-Gemma和Llama-3.2。在本文的主要分析中(癌症类型分类、生存预测和患者检索),研究团队使用了GatorTron嵌入,因为其在临床文本上的专业训练。
全切片图像(WSI):支持UNI(ViT-L/16,307M参数)、UNI2-h(ViT-g/14,632M参数)和Virchow2(DINOv2,1.1B参数)。UNI提供1024维嵌入,针对效率优化;UNI2-h具有更大的架构,提供增强的特征提取能力;Virchow2基于DINOv2构建,通过在不同病理数据集上的自监督学习提供最全面的表示。
放射影像:支持RadImageNet,一个在超过四百万医学图像(CT、MRI和PET模态)上预训练的卷积神经网络(CNN)。该模型的多模态预训练使其能够处理肿瘤学中常见的多样化影像协议。
分子数据:包含SeNMo,一个自归一化深度学习编码器,专门为高维、多组学数据设计,包括基因表达、DNA甲基化、体细胞突变、miRNA和蛋白质表达。
3 多模态嵌入整合策略
HONeYBEE实现了三种融合策略:
1.拼接(Concatenation):连接可用嵌入,同时保留模态特定信息
2.平均池化(Mean pooling):在填充到共同维度后对嵌入取平均
3.Kronecker积(Kronecker product):捕捉模态之间的成对交互
在癌症类型聚类任务中,一个反直觉的结果出现了:临床嵌入单独使用就取得了最强的聚类性能(归一化互信息NMI为0.7448,调整互信息AMI为0.702),超越了所有其他单模态和所有多模态融合策略。这很可能反映了TCGA中临床文档的精心策划性质——关键的诊断变量(如癌症亚型、分期、分级和分子标志物)由临床专家提取并记录,有效总结了可能分散在原始放射、病理和分子数据中的信息。
然而,所有三种多模态融合方法都优于较弱的单模态(如分子、放射和WSI嵌入)。在融合方法中,拼接取得了最佳的聚类性能(NMI为0.4440,AMI为0.347),平均池化和Kronecker积紧随其后。
4 与现有技术的对比
传统多模态AI开发通常依赖碎片化流程,需要手动协调OHDSI、PyDicom、OpenSlide等工具,且往往只能处理单模态或双模态数据,对缺失模态的患者支持有限。基础模型通常固化在代码中,扩展性差。而HONeYBEE通过模块化、即插即用的框架,统一了API和编码器架构,支持五种数据模态,能够处理缺失模态的患者而无需完整病例队列,并通过Hugging Face生态系统实现基础模型的无缝集成和替换。其完全开源的特性也确保了嵌入和数据集的可重复性与外部验证。
实验验证与关键数据
研究团队使用来自癌症基因组图谱(TCGA)的多模态患者级数据对HONeYBEE进行了评估,涵盖33种癌症类型的11,428名患者。可用数据模态包括临床文本(11,428名患者)、分子图谱(13,804个样本,来自10,938名患者)、病理报告(11,108名患者)、WSI(8,060名患者)和放射影像(1,149名患者)。
1 癌症类型分类:临床嵌入的统治力
在癌症类型分类任务中,临床嵌入在单模态中表现最佳,准确率达到98.54%,F1分数、精确率和召回率均与之相当。病理报告嵌入次之,准确率为78.67%;分子嵌入为56.73%;放射嵌入为47.78%;WSI嵌入表现最弱,仅为28.41%。
多模态拼接融合达到了最高的整体准确率(98.72%),虽然提升幅度不大,但一致性极高——所有方法在10次独立运行中的标准差均小于1%。Kronecker积融合达到了98.50%,而平均池化则为91.97%。
2 患者相似性检索:临床嵌入的语义优势
在患者相似性检索任务中,临床嵌入表现卓越:P@10达到96.4%,失败率仅为3.6%。分子和放射嵌入的P@10分别为35.0%和34.3%,失败率均超过65%。病理报告嵌入的P@10为70.3%,失败率为29.7%。WSI嵌入的检索性能最差,P@10仅为14.3%,失败率高达85.7%。
所有多模态融合方法都未能超越临床嵌入单独使用的检索性能——拼接融合的P@10为46.1%,平均池化为44.6%,Kronecker积为26.9%。这表明整合较弱的模态反而稀释了临床嵌入中存在的强语义信号。
3 生存预测:临床嵌入在27/33种癌症中领先
在生存预测任务中,HONeYBEE嵌入显著优于现有基线方法(如SurvPath、ABMIL、MCAT、MOTCat、Porpoise和PathOmic,其一致性指数C-index范围在0.566至0.655之间)。临床嵌入在27/33种癌症类型中C-index超过0.80,在TCGA-PCPG(0.996 ± 0.007)、TCGA-THCA(0.985 ± 0.003)和TCGA-UCEC(0.935 ± 0.012)中表现尤为突出。
多模态融合在特定癌症中展现出补充价值:在TCGA-UCS中,多模态融合将C-index从0.794±0.101(临床)提升至0.836±0.070;在TCGA-UVM中,从0.844±0.042提升至0.860±0.084;在TCGA-THYM中,从0.978±0.032提升至0.983±0.033。这些改进表明,对于某些癌症类型,整合多模态的互补信息能够实现比单纯依赖临床文档更准确的生存预测。
4 大语言模型对比:通用模型意外胜出
研究团队对四种大语言模型进行了系统评估:GatorTron(医学编码器)、Qwen3(通用编码器)、Med-Gemma(医学解码器)和Llama-3.2(通用解码器)。
核心发现:通用目的的Qwen模型在临床文本嵌入上取得了最高的分类准确率(99.95%)和检索精度@10(99.57%),超越了专门为医学领域设计的GatorTron和Med-Gemma。GatorTron的临床分类准确率为98.66%,Med-Gemma为99.52%,Llama-3.2为99.49%。这表明大规模通用模型可能编码了更广泛的语义结构,能够有效迁移到临床任务中。
在病理报告的分类任务中,所有模型的准确率均有所下降,范围在78.41%至84.90%之间,其中解码器模型表现略好。在检索任务中,临床嵌入的P@10普遍超过95%,而病理报告嵌入的P@10则在70%至78%之间。
5 微调的力量:病理报告嵌入的飞跃
鉴于病理报告的基线性能较低,研究团队探索了任务特定微调是否能改善嵌入质量。微调带来了7.8至12.7个百分点的准确率提升:GatorTron从78.41%提升至91.07%,Qwen从84.90%提升至92.73%,Med-Gemma从84.05%提升至94.29%,Llama-3.2从82.45%提升至92.96%。AMI分数也从约0.35-0.39提升至0.91-0.93。
这表明参数高效微调可以有效弥合原始文本和精心策划文本之间的性能差距,对于处理异构且结构化程度较低的模态(如病理叙述)尤为重要。
影响与未来
1 对肿瘤学AI行业的意义
HONeYBEE的出现,标志着肿瘤学多模态AI从“手工作坊”向“标准化工厂”的转变。其开源性质、模块化设计和与Hugging Face生态系统的无缝集成,大幅降低了多模态AI开发的门槛。
“HONeYBEE通过统一的API和编码器架构,标准化了数据摄入、嵌入生成和融合,解决了跨模态元数据协调和管理不一致API的技术开销。”
对于投资者而言,HONeYBEE代表了一种可扩展的基础设施层——它不直接做药物发现或临床决策,而是提供底层嵌入生成能力。这种“卖铲子”的定位,使其具有平台型商业潜力。
对于科技从业者,HONeYBEE的模块化架构意味着可以轻松替换或升级任何模态的基础模型。论文中已经展示了从GatorTron到Qwen3的切换,以及微调带来的显著提升——这种灵活性是传统固化流程无法比拟的。
2 商业化路径与落地场景
HONeYBEE的嵌入向量具有紧凑、可互操作的特点,可与FAISS、Annoy等向量数据库系统集成。这意味着它可以支持:
-
1. 检索增强生成(RAG):在临床决策支持中,快速检索相似患者病例 -
2. 风险分层:基于多模态嵌入的患者风险分组 -
3. 临床分诊:自动化患者优先级排序 -
4. 生物标志物发现:跨模态假设生成 -
5. 联邦学习:由于嵌入可在本地生成而无需共享原始数据,HONeYBEE支持安全的、多机构的模型开发
“由于嵌入可以在不共享原始数据的情况下本地生成,HONeYBEE促进了联邦学习协作,推动了跨多样化肿瘤学数据集的安全、多机构模型开发。”
3 未来方向
研究团队明确指出,未来工作将聚焦于:
-
• 将HONeYBEE扩展到前瞻性临床数据 -
• 评估嵌入在治疗反应预测中的效用 -
• 整合基因组学、放射组学和可穿戴传感器数据等额外模态
结尾:冷静的审视
HONeYBEE无疑为肿瘤学多模态AI树立了一个新的工程标杆。其开源、模块化、可扩展的设计哲学,以及对基础模型生态系统的深度整合,使其具备了成为领域基础设施的潜力。在11,400+名患者、33种癌症类型上的验证,以及临床嵌入98.5%的分类准确率和96.4%的检索精度,都是令人印象深刻的数字。
然而,冷静地审视,这项技术距离大规模临床应用仍有距离。
首先,TCGA数据集的高度策划性质意味着临床嵌入的统治力可能被高估。在真实世界的临床环境中,临床文档往往不完整、不一致或缺乏详细注释——这正是论文作者自己承认的。多模态融合的真正价值,可能需要在质量参差不齐的真实世界数据中才能充分体现。
其次,放射影像模态的样本量严重不足(仅1,149名患者,覆盖4种癌症类型),限制了对其潜力的评估。WSI嵌入的失败率高达85.7%,也提示当前的全切片图像基础模型在患者级表示上仍有很大提升空间。
第三,通用大模型Qwen3在临床文本上的胜出,虽然令人兴奋,但也引发了对数据隐私、模型可解释性和监管合规的担忧。在医疗领域,一个“黑箱”通用模型的决策依据,可能比一个性能稍逊但可解释的专业模型更难获得监管批准。
第四,从嵌入到临床行动之间仍有鸿沟。嵌入向量本身不直接告诉医生该做什么——它们需要被集成到临床工作流中,经过前瞻性验证,并证明能够改善患者结局,而不仅仅是提高分类准确率。
但总体而言,HONeYBEE的方向是正确且必要的。肿瘤学的复杂性决定了任何单一模态都无法捕捉其全貌。HONeYBEE提供了一条标准化、可扩展、可重复的路径,让多模态整合从“可能”走向“可行”。随着基础模型的持续进化、真实世界数据的积累和监管框架的完善,我们有理由对肿瘤学多模态AI的未来保持乐观——而HONeYBEE,很可能成为这个未来的基石之一。
参考资料
Tripathi, A., Waqas, A., Schabath, M.B. et al. HONeYBEE: enabling scalable multimodal AI in oncology through foundation model-driven embeddings. npj Digit. Med. 8, 622 (2025). https://doi.org/10.1038/s41746-025-02003-4
审核 | 医工学人理事会
