





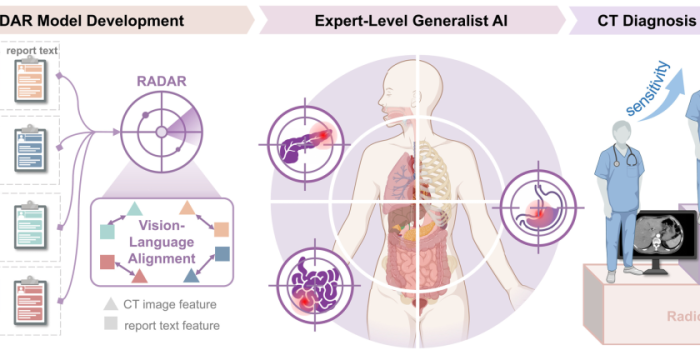
2026年9月17日,阿里达摩院与浙江大学医学院附属第一医院等机构在 Science 发表RADAR(Rapid Abdominal Diagnosis with AI and Radiology)。
该方案不另做切片级标注,按解剖拆开CT和报告做图文对齐,一个模型覆盖18个结构、146项发现。内部连续队列39,160例平均AUC 0.913(95% CI 0.911–0.915);八家外中心单中心AUC 0.874–0.912。它不是一张三类证,也不是PACS里一键出报告的商品,而是把“通用影像AI能不能在最难的腹部站住”写成可核验数字的一次试验。
专病堆叠填不满的腹部清单
2016年,深度学习先驱、诺贝尔物理学奖得主Geoffrey Hinton在多伦多一场产业会上说,深度学习五年内或十年内会超过放射科医生,医学院不该再培养那么多阅片人。
十年过去,肺结节、眼底、骨折的辅助检测软件已经能拿证进院,可腹部增强CT仍是另一回事:一次检查里肝、胆、胰、脾、胃肠、肾、肾上腺和血管挤在同一套期相里,病灶常常只占很小一块软组织,报告要同时写疾病和征象。专病模型可以在单一任务上把AUC做到0.98,却养不起一百多个并行系统。
国内已经落地的影像AI,主战场仍是单任务。截至2025年4月末,NMPA获批的AI肺结节检测三类证约19张,适应证多写“4 mm及以上肺结节自动识别,供经培训医师使用,不能单独作为诊疗依据”。2021年至2026年年中,人工智能医用软件累计批准约127张,其中三类证约126张,肺结节/肺部影像和心血管最挤,腹部多病种几乎是空档。达摩院自己也走了这条专病路:2023年 Nature Medicine 的PANDA用平扫CT做胰腺病变检测,多中心AUC 0.986–0.996,真实世界20,530例敏感度92.9%、特异度99.9%;2025年胃癌GRAPE、急性主动脉综合征模型同样登 Nat. Med.。专病可以很准,维护成本按病种线性涨:每个任务要标注、要注册、要跨机型复测。
腹部把这个账算得更清楚。RADAR作者写明,相对胸片或胸部CT,腹诊更难:器官种类多、形态和空间关系变化大、病灶与正常组织对比低。2026年3月斯坦福Merlin在 Nature 把腹部CT视觉–语言模型往前推了一步,公开测试集5,137例、30项发现;RADAR论文里Merlin在同一套RAD-CT上重训后的对照AUC约0.71量级,远低于通才要碰到的临床门槛。达摩院团队此前的fVLM(ICLR 2025)能认54类腹部CT疾病,仍是概念验证。RADAR要做的,是把清单一次拉到146项,并且不靠人工逐片标注。
器官级对齐:先拆解剖,再拉近图文
训练数据叫RAD-CT:浙大一院2010年1月至2023年12月非急诊腹部增强CT,424,911次检查、1,497,673对容积级图文,解剖拆解后超过1,500万对。内部测试与训练按时间切开——2024年1–6月连续39,160例,避免同一患者泄漏。方法上有三块,都写在Fig. 1。
视觉支是按nnU-Net自动配置的3D U-Net,分割解码器做解剖感知。先在TotalSegmentator上把104个亚结构合并成36个主解剖,再落到腹扫可见、且分割可靠的18个目标;训练后期用公开分割模型在全训练集上打伪标签,Dice加交叉熵把空间定位保住。每个解剖用可学习query做交叉注意力,压成一条视觉嵌入。文本支是BERT-base(768维、12层),吃的不是整份报告,而是Qwen拆出来的解剖子报告;某器官报告里没写,按临床惯例补“未见明显异常”。
对齐不在整卷和整份报告上做。批次里同一患者、同一解剖的图文被拉近,不同个体被推开。作者认为整卷对齐会被大片正常背景淹没,诊断信号太稀。自适应对比再补一层:标成正常的解剖,跨患者也可以当正样本;异常描述则用动量文本编码器估语义相似度,相近病变给软监督,减少“都是肝癌、左右叶不同”被硬推开的假阴性。实现细节:体素重采样1×1×5 mm,HU裁到[–300, 400],随机裁块96×256×384,只训练裁块内完整的器官;24张H20、总batch 48、30个epoch。
推理也不用再微调。每个发现做一对提示:正例写“结肠炎”或“胰腺肿胀、胰周渗出;胰腺炎”,负例写“未见结肠炎/无××证据”。文本编码后与对应解剖的图像特征算余弦相似度,分高的一侧即预测。多期相取平扫、动脉、静脉三者分数的最大值。Grad-CAM把对正提示贡献大的区域画成注意图,读片试验里和预测清单一起给医生。
内部0.913,急诊未训练也能到0.904
内部146项平均AUC 0.913,比同数据上重训的fVLM(0.776)高0.137(P<0.001),也明显高于CT-CLIP和Merlin。按18个解剖,AUC落在0.838–0.982;七个功能系统0.896–0.964;实质器官0.918、空腔器官0.907;疾病0.914、征象0.911;良性0.910、恶性0.929。门脉高压相关共病(肝硬化、门脉高压、食管静脉曲张、胃底静脉曲张、脾大)在补充图里仍能一起被认出,说明解剖级训练没有把多器官病理拆散。
急诊队列27,267例、17种常见急腹症,模型训练时故意排除急诊数据,平均AUC仍有0.904(0.900–0.909)。三期融合优于单期。监督对照里,ViT平均AUC 0.787,nnU-Net+为0.868,RADAR分别高0.126和0.045;低频发现上两条监督曲线掉得更明显。数据量加大,性能还在升,作者写成尚未饱和的缩放。
提示集成把内部AUC从0.913抬到0.928;按发现做提示对齐微调后,内部0.940、外部从0.895到0.927。这是后处理,不是主结论,但说明提示措辞和少量监督还能再挖一点。
八中心外推,病理与斯坦福队列卡住“只在本院好用”
外验证收了安吉、北仑、海宁、景宁、绩溪、余杭、嵊州、新疆生产建设兵团第一师医院等八家,共24,239例增强腹扫,场景含急诊、住院、门诊和体检,扫描范围从全腹到盆腔,每中心标注发现68–136项。八中心平均AUC 0.895(0.889–0.900),单中心0.874–0.912,家家压过三个对照模型。一半以上解剖的内外AUC差小于0.01。相对内部,RADAR只掉0.018,ViT掉0.032,nnU-Net+掉0.050。
报告标签不是病理。作者另收嘉兴大学附属医院、嵊州人民医院两家病理队列共4,333例:结直肠癌648、胰腺癌388、胃癌537、肝细胞癌383,对照2,377。两中心四癌AUC 0.891–0.984,与八家真实世界里这四癌的区间大致重叠。训练吃的是报告语言,金标准换成手术或活检,曲线没有塌。
跨人群用的是斯坦福Merlin-CT-Test(5,137例,以西方患者为主,30项发现)。未在Merlin上训练时,RADAR在21项“有明确器官、且当前分割覆盖”的子集上AUC 0.883(0.871–0.891),BiomedCLIP 0.574、MedGemma1.5 0.555、Lingshu 0.581。允许用Merlin训练集时,Merlin本身0.812,RADAR从零训练0.888,RADAR+(RAD-CT预训练再微调)21项0.918、30项全覆盖0.876。九项被排除,是因为找不到清晰器官对应,或分割器还不会——通才边界写在表1里。
读片试验:敏感度加10个百分点,时间少三成
临床效用不看再多一张ROC,而看医生改不改报告。300例增强腹扫、61项发现;14家医院26名放射科医师,按年资和医院等级分成四组:三级甲等高年资4人、低年资6人,其他医院高年资7人、低年资9人。高年资定义为临床经验>10年。第一轮独立写报告:特异度一律很高(98.8%,98.6–98.9%),敏感度随年资和医院层级拉开;多数人的工作点落在RADAR曲线下方,只有三名高年资略好于模型。至少间隔一个月后,同一批病例乱序重读,RADAR给出预测清单和Grad-CAM注意图。
辅助后敏感度升10.0个百分点(P<0.001),特异度从98.8%降到98.2%,每例阅片时间少30.7%(P<0.001)。三甲医院里,AI辅助的低年资敏感度比无辅助高年资高3.4个百分点(P=0.24);其他医院低年资辅助后升10.1个百分点,达到同级无辅助高年资水平。恶性发现+7.3%,急诊场景+8.5%,空腔脏器疾病+9.4%。Fig. 4H里膀胱癌、胆囊癌、胃癌等漏诊,注意图标出后检出率明显上去,低年资更明显。媒体转述的“26人里23人低于模型、低年资加AI追上高年资”,对应的是这组读片设计,不是另一次竞赛。
从PANDA到开源权重,进院还差注册路径
代码已放到Zenodo(10.5281/zenodo.21504519),GitHub仓库alibaba-damo-academy/damo-radar,Hugging Faceradar-generalist/RADAR提供RAD-CT预训练权重、U-Net视觉支、以及在Merlin上从零训练或微调的RADAR+。这和肺结节软件“买断或按次计费进PACS”不是同一类交付:RADAR是研究框架加权重,提示词、分割覆盖、中英文BERT要按现场报告语言再接。
产品落地必须把话说死。论文没有NMPA、FDA或CE注册数据;适应证若按146项去报三类证,审评路径、金标准、跨厂家CT和重建核的可重复性都还没走。监督模型在低频病上掉得快,通才用报告语言换来覆盖,也把报告错误和“阴性即正常”的书写习惯写进了模型。作者自己列的限制有两条:发展阶段缺少全面病理金标准,只对关键发现做了靶向病理验证;跨人群验证还不充分,Merlin 21项子集不能代表全球腹扫。平扫期在急诊和远程场景有额外价值,但主任务仍是增强CT。专利已申请,不等于可以部署到临床决策链上。
对公众更有用的判断,不是Hinton式的“还要不要培养放射科医生”。读片试验里特异度几乎没动,敏感度的10个点和30%时间,来自清单加注意图,不是模型替医生签字。三甲高年资仍有人压过曲线,基层低年资涨得最多——这更像把报告质量的方差压窄,而不是替换岗位。下一张该看的不是更高的内部AUC,而是前瞻、跨厂商、带病理随访的辅助阅片,以及监管能否接受“提示查询、发现清单不固定”这种通才形态。在那之前,RADAR证明的是:腹部这根最硬的骨头,用解剖级图文对齐可以啃到专家工作点附近;专病证书堆成的产品目录,还填不满同一张CT。
参考资料
主要来源: Zhang等,Science 393, eaec6129 (2026),DOI: 10.1126/science.aec6129;Blankemeier等,Merlin,Nature 652, 1318–1328 (2026);Cao等,PANDA,Nat. Med. 29, 3033–3043 (2023);Hu等,GRAPE,Nat. Med. 31, 3011–3019 (2025);Shui等,fVLM,ICLR 2025;NMPA人工智能医用软件公开统计(2021–2026年中);Hinton,2016 Machine Learning and the Market for Intelligence;GitHub alibaba-damo-academy/damo-radar;Hugging Face radar-generalist/RADAR。
审核 | 医工学人理事会
